2026-09-30 15:11:05 西盟科技资讯
引言
随着端侧AI推理应用的不断深入,RK3588凭借其强大的多媒体处理能力和通用计算性能,已成为嵌入式边缘计算领域的明星平台。然而,其内置NPU仅6TOPS的算力在面对Qwen等大模型的高负载推理时,逐渐暴露出性能瓶颈。在运行3B及以上的模型时,推理速度明显变慢,难以满足日益增长的实时性需求。
正是在这一背景下,瑞芯微于2025年推出了RK1828端侧AI协处理器。该芯片采用M.2 2280标准形态,通过PCIe接口与主控平台高速互联,可实现即插即用式的算力扩展。RK1828搭载专用NPU,INT8峰值算力高达20TOPS,并内置5GB 3D堆叠高带宽DRAM,专门承接高负载AI推理任务。凭借“主控统筹+协处理器专职加速”的异构架构,RK3588与RK1828的组合正成为边缘AI大模型产品极具竞争力的硬件底座。
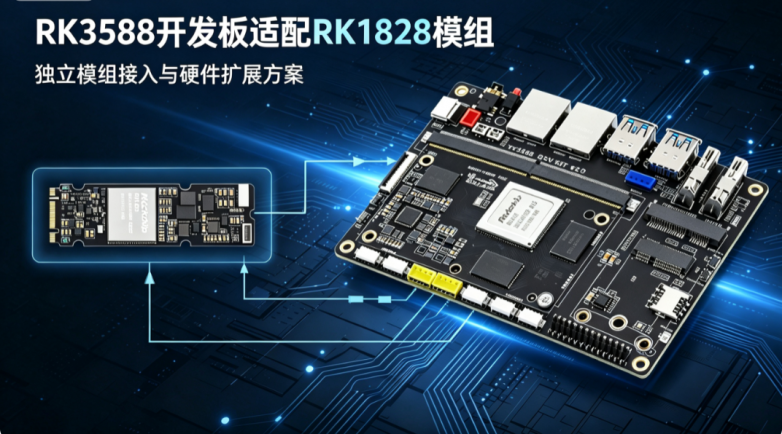
本文将从硬件平台搭建、系统软件适配到推理性能验证,完整记录RK3588开发板上适配RK1828 M.2模组的全过程,并通过大模型对话的实测数据,直观展示RK1828相比RK3588自带NPU的性能提升幅度。
硬件平台搭建
硬件选型
本文选用的主控平台为风火轮技术推出的YY3588开发板。该开发板基于瑞芯微RK3588芯片打造,采用核心板+底板的模块化设计,核心板尺寸为82mm×53mm,默认底板尺寸为120mm×88mm,兼具高性能与紧凑体积。RK3588搭载八核64位CPU(4×Cortex-A76@2.4GHz + 4×Cortex-A55@1.8GHz),集成6TOPS NPU,适合工业控制、边缘AI等多元化应用场景。
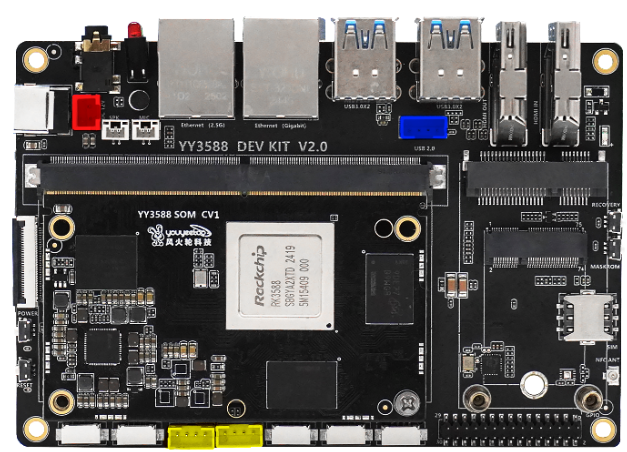
YY3588开发板板载一路M.2 M-Key接口,支持NVMe 2280 SSD固态硬盘,走PCIe 3.0总线。该接口可直接接入本次适配的RK1828 M.2模组。
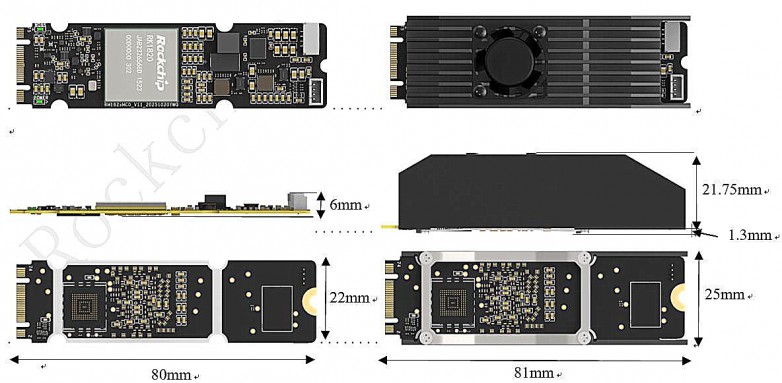
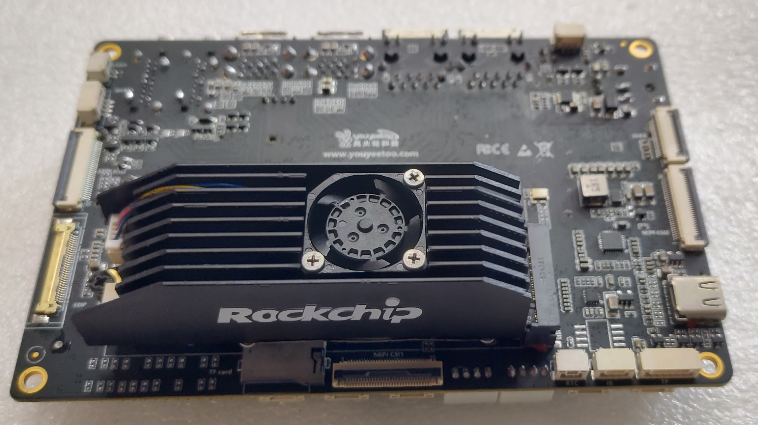
AI协处理器模组选用瑞芯微RM182XMC0。该模组采用M.2 Key B-M连接器,物理尺寸为22mm×80mm×6mm。模组内置RK1828协处理器芯片,基于三核64位RISC-V架构,搭载专用NPU引擎,INT8峰值算力高达20TOPS,并内置5GB高带宽DRAM。模组支持PCIe 2.1接口,单 Lane 运行,数据传输速率最高可达5.0Gbps。此模组形态如下
硬件安装步骤
步骤一:检查接口兼容性。确认YY3588开发板的M.2插槽为M-Key规格,支持PCIe 3.0信号。RK1828模组采用Key B-M连接器,两者在物理接口和电气信号上兼容。
步骤二:安装模组。 将RK1828模组的金手指对准YY3588开发板的M.2插槽,使用配套螺丝将其固定于底板上的铜柱螺孔。
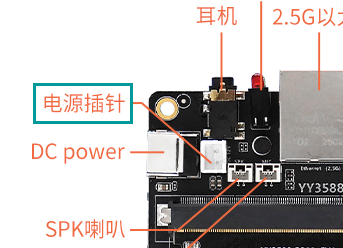
步骤三:连接供电。 RK1828模组需要独立的12V主供电输入。根据规格书,VCC_IN供电电压范围为8.0V至14.4V,典型值为12.0V;3.3V供电电压范围为2.97V至3.63V,典型值为3.3V。YY3588上面有一个电源插针,在下图所示的位置,此电源插针和DC电源座是通的,将RM182XMC0配套电源线插到这个座子上面即可。
步骤四:上电启动。 完成上述安装后,为YY3588开发板上电,系统正常启动。此时,RM182XMC0上面的风扇也会转动。
硬件识别验证
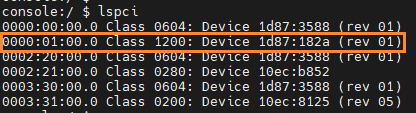
系统启动后,可在YY3588开发板的串口通过以下命令验证RK1828模组是否被正确识别:
lspci
预期输出中应出现VID为1d87 PID为182a的设备
常见问题排查
1、RM182XMC0风扇不转,指示灯不亮
检查12V电源是否接反,电源电流是否足够。预留给RK1828模组应至少达到2A,不然可能出现不开机的情况。
2、RM182XMC0上电,PCIE不识别
检查一下dmesg里面是否有报错信息,正常情况下,会是这样的信息
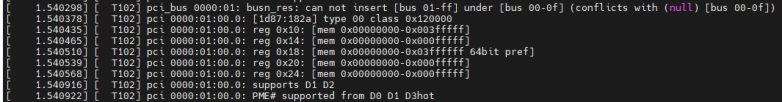
如果枚举失败,有可能是接触不良
完成硬件识别验证后,即可进入下一阶段的系统软件适配工作。
软件适配(基础部署)
系统软件层面的适配工作,主要包括内核驱动配置、RK1828固件与运行时库的安装部署,以及环境验证。本章基于瑞芯微官方提供的RK1820/RK1828 AI SDK(Release V1.1.0)进行说明。此SDK框架如下图所示
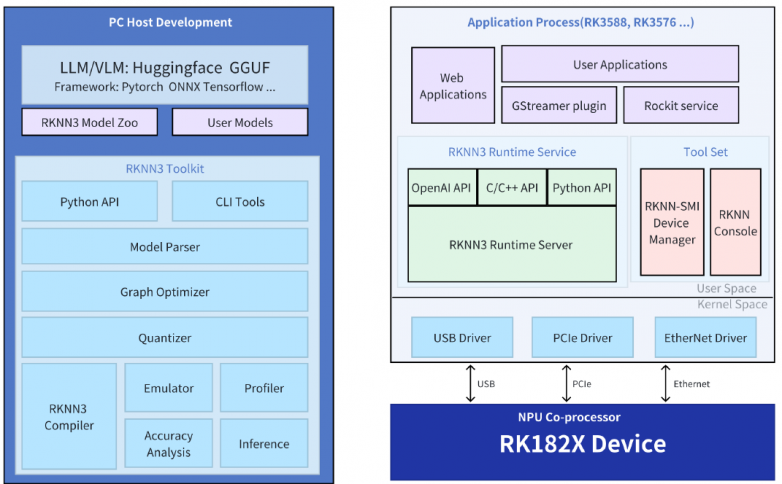
此SDK框架与RK3588上面运行的RKNN2有相似之处,都包含了PC端的RKNN Toolkit与主控端的RKNN Runtime。不同的是,使用RK1828时,还需要主控加载USB/PCIe/Ethernet驱动,与RK1828通信。使用这个M.2接口的RK1828模块时,使用的是PCIe通道。
系统与环境准备
Host端系统要求:本文使用的YY3588开发板,开发板上安装android系统。要使用RK1828的PCIE驱动,要求内核版本需不低于5.10。
SDK获取:从瑞芯微官方渠道获取RK1828 M.2模组对应的预编译软件安装包 rknn3_rk182x_m2_v1.1.0_installer_arm64.tgz。该安装包包含了RK1828固件、RKNN3 Runtime、调试工具集(rknn-smi、rknn-console)等。
内核驱动配置
内核驱动配置有如下两个方法,任选其一
1、若需自行编译内核以启用PCIe EP功能支持,需在Rockchip SDK内核源码中确认已合入相关补丁,对于Linux kernel 6.1版本的SDK,此补丁的说明如下
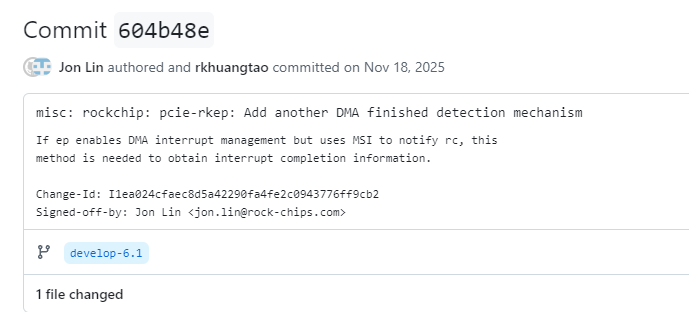
此补丁只是改了drivers/misc/rockchip/pcie-rkep.c文件,单独把这个文件拉下来放SDK里面替换也是可以的。
并确认开启以下内核配置项:
CONFIG_PCIE_FUNC_RKEP=y
CONFIG_PCIE_DW_DMATEST=y
配置完成后重新编译内核并烧录至YY3588开发板。
2、RK也提供了一个单独抽出来的rkep驱动文件夹,此文件夹内容如下
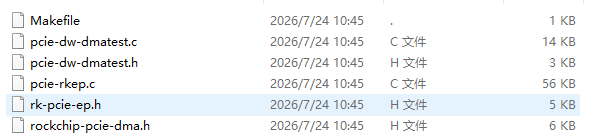
将这几个文件放到drivers/misc/pcie-rkep目录下面,然后修改drivers/misc/ Makefile,增加一行
obj-y += pcie-rkep/
然后重新编译内核,即可得到 drivers/misc/pcie-rkep/pcie-rkep.ko 文件,将此文件通过adb等方式推到板端,并执行 insmod pcie-rkep.ko
无论采用上述哪种方式,成功加载后,都可以看到如下dmesg信息
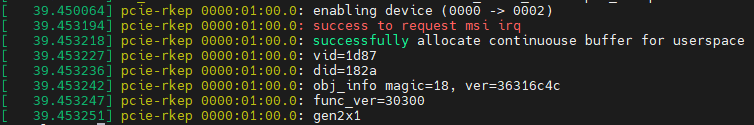
同时/dev目录下出现 pcie-rkep-XXXX:XX:XX.X节点,其中XXXX:XX:XX.X取决于使用的PCIE端口号。
RKNN3Runtime配置
解压rknn3_rk182x_m2_v1.1.0_installer_arm64.tgz后,得到如下内容
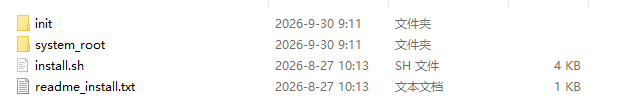
这里面包含了Linux和Android两个平台的二进制可执行程序和动态库。下面仅以Android的部署方式为例说明,Linux是类似的。
1、加载RK182X固件。
RK182X模组没有存储器,固件是放在合封的DDR里面运行的,因此每次上电,都需要主控把它的固件发过去。
固件路径:system_root/firmware/rknn3_rk1820_ext-m2.img
下载工具:system_root/bin/pcie_upgrade_tool(主控运行Linux和Android时一样)
将固件和下载工具放到板上,然后执行
pcie_upgrade_tool uf rknn3_rk1820_ext-m2.img -reset
即可下载。下载时会有如下打印信息
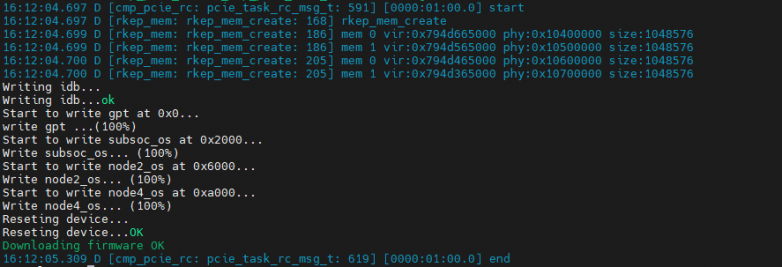
注:下载固件前,RK182X风扇处于最高转速。下载固件后,RK182X在温度较低时,风扇会处于低转速或者不转,即动态调温策略会生效。
2、部署动态库
如果是android系统,动态库位于system_root/lib/MultiSys/Android/文件夹,把这个文件夹里面所有文件推到板端的/vendor/lib64即可
如果是linux系统,动态库位于system_root/lib/文件夹,把这个文件夹里面.so后缀的文件推到板端的/usr/lib64即可
验证环境是否生效,可将 system_root/bin/rknn-smi(Linux)或 system_root/bin/MultiSys/Android/rknn-smi(Android)推到板上,执行 rknn-smi -v。如果配置正确,能看到如下打印信息:
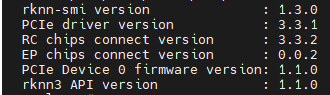
注意 PCIe Device 0 firmware version 是RK182X的固件版本,rknn3 API version 是主控端动态库版本,二者必须一致
3、启动传输服务
主控和RK182X之间需要传递模型数据等,这里需要使用到 rknn3_transfer_proxy 工具。
linux的在 system_root/bin/rknn3_transfer_proxy
android的在 system_root/bin/MultiSys/Android/rknn3_transfer_proxy
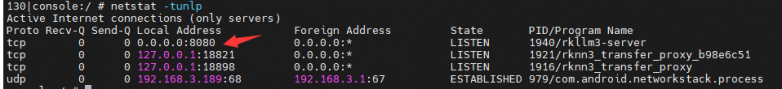
将这个文件推到板上,直接执行 rknn3_transfer_proxy &,此时使用 netstat命令可以看到如下两个端口被打开了

到这里就完成了runtime的部署。
RK182X大模型对话功能演示
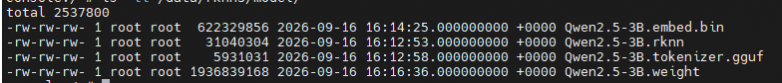
与RK3588/RK3399PRO这些平台一样,需要把通用模型转换为RKNN模型后,才能在板端NPU运行。笔者这里以RK训练好的3B模型为例。下载RK提供的模型后,可以得到如下四个文件,把这四个文件推到板上
然后需要使用RK提供的一个openAI server端软件,这样可以通过openAI接口与之对话。
linux的在 system_root/bin/rkllm3-server
android的在 system_root/bin/MultiSys/Android/rkllm3-server
将这个文件推到板上,执行
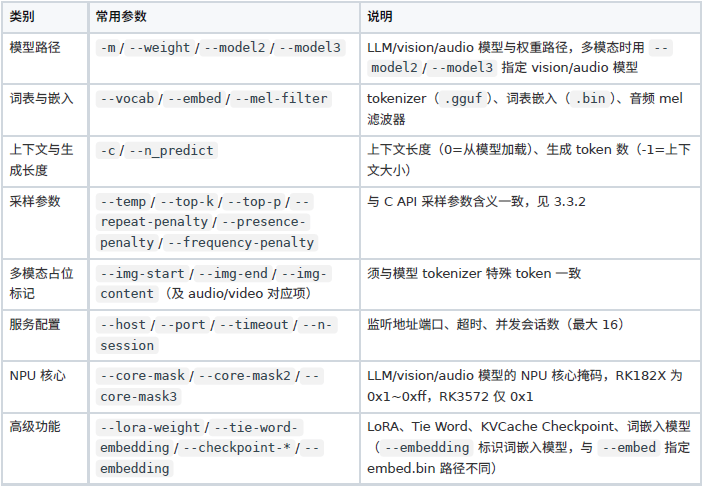
rkllm3-server -m /xxx/Qwen2.5-3B.rknn --weight /xxx/Qwen2.5-3B.weight --vocab /xxx/Qwen2.5-3B.tokenizer.gguf --embed /xxx/Qwen2.5-3B.embed.bin --host 0.0.0.0 --port 8080 -c 768 --n_predict 512 --repeat-penalty 1.1 --presence-penalty 1.0 --frequency-penalty 1.0 --top-k 1 --top-p 0.8 --temp 0.8
这些参数的定义如下
执行之后,可以用netstat看到有如下端口被打开了
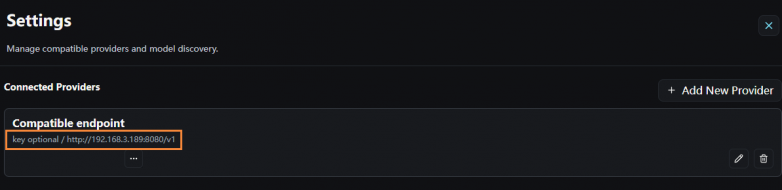
部署完成后,可以使用Navi这款工具与RK3588上面开放出来的openAI兼容端口连接,Navi的配置如下所示,IP填入YY3588板子的IP,PC要跟板子在同一局域网。
然后发起对话
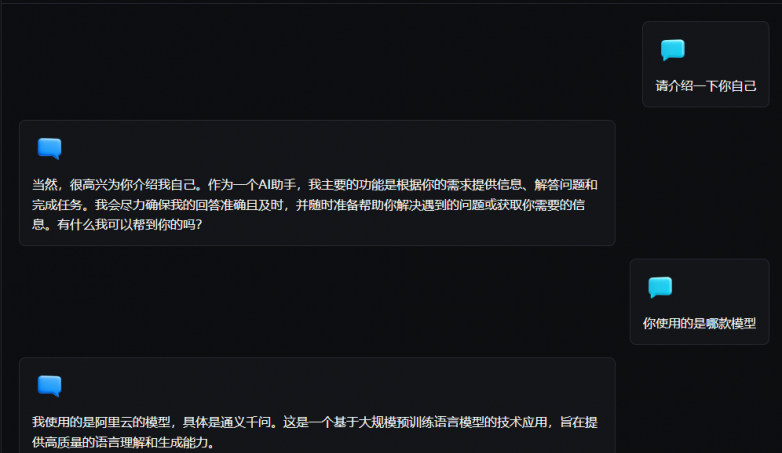
对话之后,在logcat日志里面,可以看到其运行耗时,消耗的token等信息
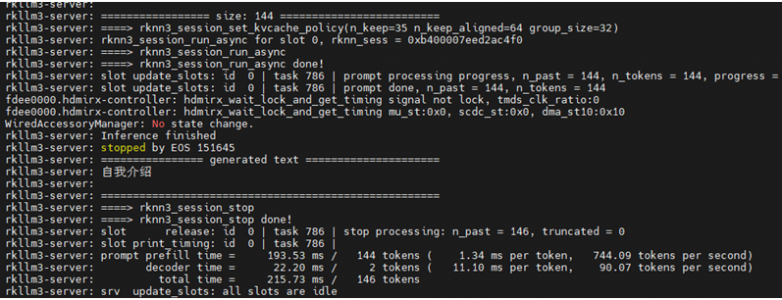
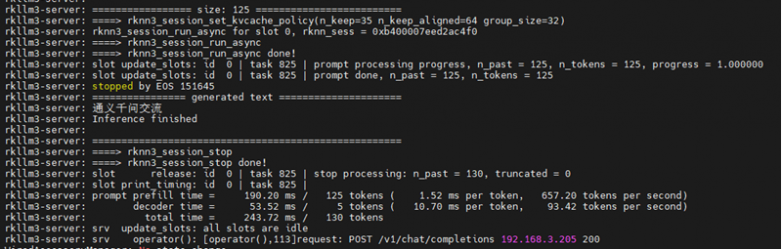
从日志中可以看到,在这个 RK3588 + RK1828 平台上,运行 3B 模型,预填充 prompt prefill 速度高达 700+ tokens/秒,总耗时极低。而笔者此前测试过,在 RK3588 平台上,运行 1.5B 模型,只能达到 60 tokens/秒左右的速度。相比之下,RK的新架构非常适合跑大模型,而RK3588这种处理器自带的NPU在面对大模型时确实存在算力瓶颈。
结语
本文从硬件连接、系统配置、驱动加载、软件部署到最终的推理性能验证,完整记录并分享了在RK3588(YY3588)平台上适配RK1828 M.2 AI协处理器的全过程。
通过实测数据可以直观地看到,RK3588与RK1828的“主控+协处理器”异构架构带来了显著的性能飞跃。在运行3B参数规模的大模型时,RK1828凭借其20TOPS的专用NPU算力与5GB高带宽DRAM,推理速度快,无明显卡顿感觉,彻底解决了RK3588自带6TOPS NPU在运行大模型时推理速度缓慢、难以满足实时性需求的痛点。
随着端侧AI向更大参数量、更高实时性方向演进,RK1828 M.2模组以其标准化的接口、即插即用的算力扩展能力,为边缘计算设备提供了一条极具性价比的升级路径。未来,我们期待基于该异构平台,进一步探索多模态大模型、端侧Agent等更复杂的应用场景,充分释放边缘AI的潜力。