2026-11-13 11:13:23 西盟科技资讯
近日,全球AI 模型评测平台 Arena 更新 Code Arena|WebDev 总榜(Overall)。Arena 是业内公认具备高公信力的大模型综合评测平台,与 AA 智能指数并称为全球两大权威大模型评测榜单。平台核心采用匿名成对比对、人类偏好投票的评测框架,评测结果参考价值突出。该机制很难通过针对性优化刷榜,能够真实反映模型的实际能力水平。
云知声自研的新一代高性能模型U2-Flash以1611分的优异成绩,在模型榜(Models)的157款参评模型中位列全球第34。
从同榜模型成绩来看,U2-Flash超过智谱GLM-5.3-Flash(1609分)、Anthropic Claude Haiku 5.5 (High)(1594分)、MiniMax-M3.1-Flash(1585分)、OpenAI GPT-6 Luna (Max)(1577分)、阶跃星辰Step 5Preview (High)(1573分)和字节跳动Seed2.1 Pro Preview(1519分)等模型。
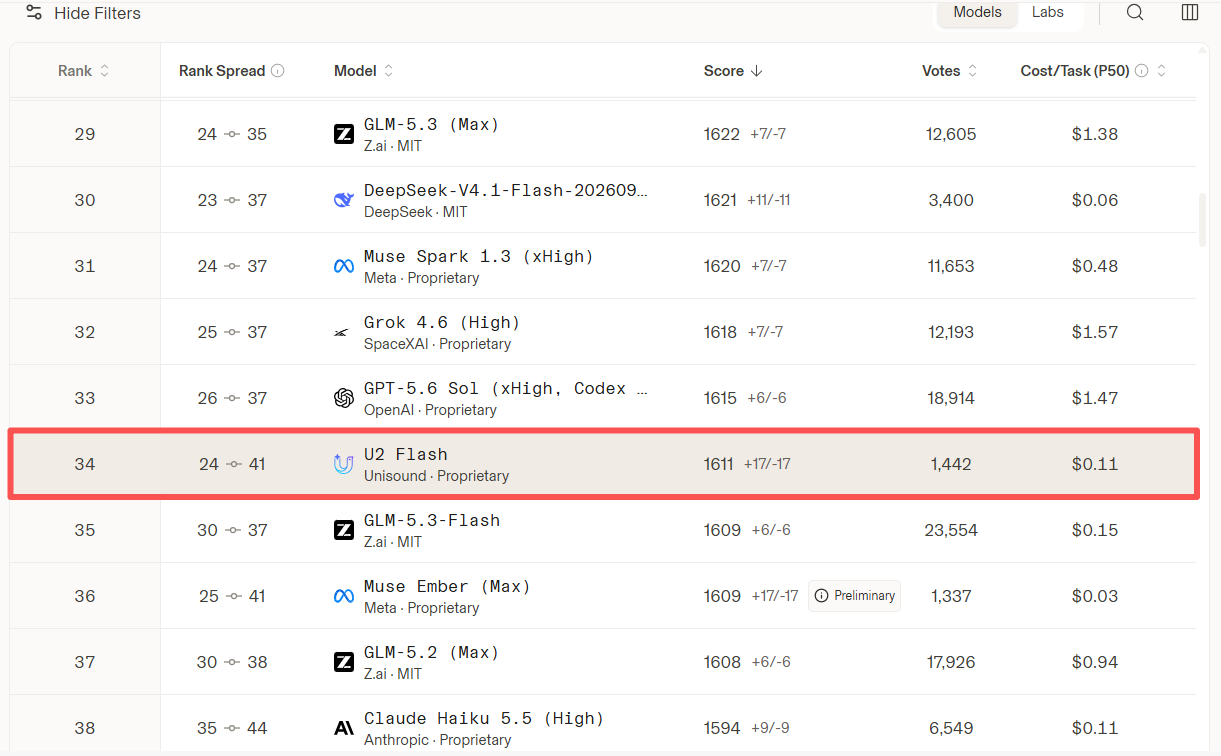
Code Arena|WebDev模型榜(Models)
在按各机构最高得分模型排序的机构榜(Labs)中,云知声凭借U2-Flash的成绩位列全球第13、中国第7,排名高于MiniMax(全球第14)、阶跃星辰(第15)、Mistral AI(第16)、字节跳动(第17)和英伟达(第20)。
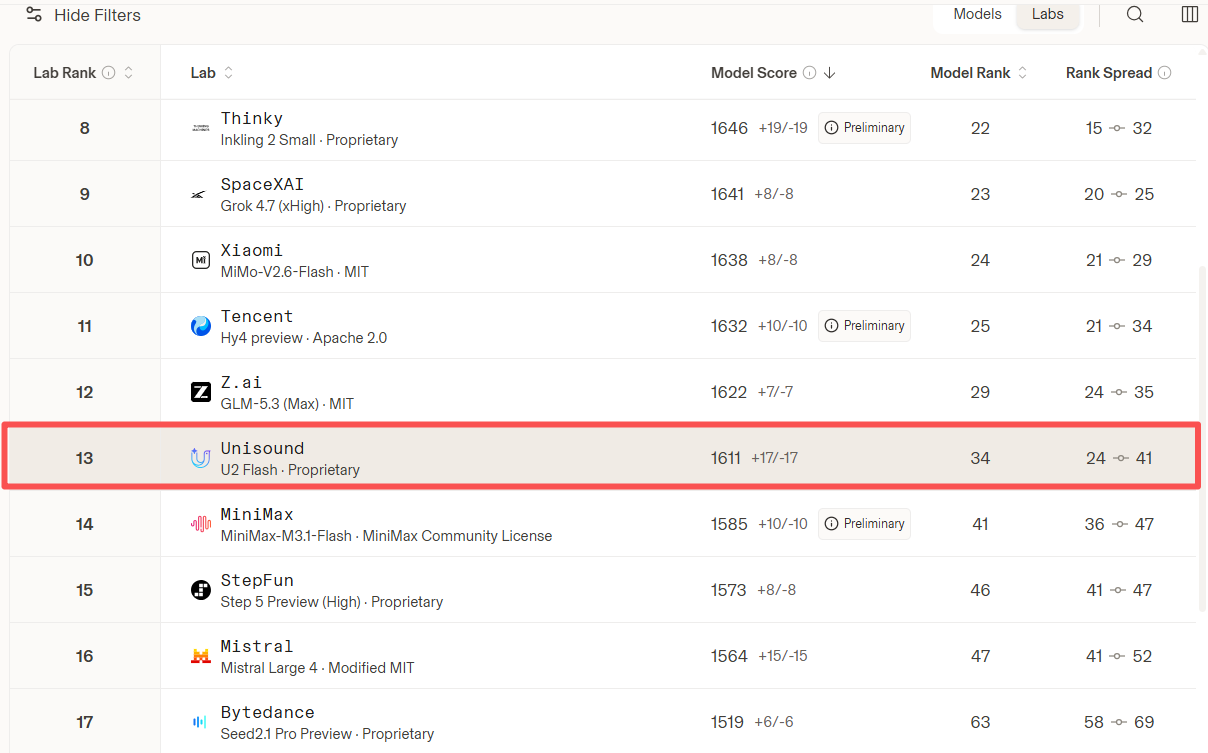
Code Arena|WebDev机构榜(Labs)
此次成绩体现了云知声U2-Flash 在前端开发任务中展现出的任务理解、多步骤推理、代码生成和工具使用等综合能力,也为其面向真实开发需求的Coding 实战能力提供了进一步验证。
点击链接查看Arena WebDev官方榜单:
https://arena.ai/leaderboard/code/webdev
01 从需求理解到成果交付,检验AI Coding 实战能力
衡量AI 的 Coding 能力,不仅要看它能否写出代码,更要看它能否围绕开发目标,完成从需求理解到成果交付的全过程。
面对真实开发任务,用户往往不会给出详细步骤,而是提出一个目标。AI 需要理解意图、拆解任务、进行多步骤推理,必要时调用工具,并根据执行情况调整方案,最终交付符合需求的成果。这个过程考验的是模型从理解、规划到执行的综合能力。
以网页开发为例,AI 不仅要写出代码,还要把用户的想法转化为页面和功能,协调设计、交互与实现等多个环节,最终完成一个可运行的网页。
Arena Code Arena|WebDev 榜单,是检验 AI Coding 综合能力的一个具体场景。该榜单以实际编程任务为载体,涵盖需要多步骤推理和工具使用的智能体式编码工作流,考察模型从需求理解、任务规划到代码实现的综合表现。
U2-Flash 此次在该榜单中的表现,展现了其在任务理解、多步骤推理、代码生成和执行方面的能力。从自然语言需求出发,到完成网页成果,U2-Flash 在这一评测场景中体现出将用户意图转化为实际结果的 Coding 实战能力。
02 从工业级Coding 到智能体编程,持续提升任务执行能力
U2-Flash是云知声面向真实任务打造的新一代高性能模型,具备推理、办公、Coding与Agent等能力。模型以系统性后训练和自主强化智能演进(RSI)为重要技术路径,持续优化复杂任务中的推理、规划与执行能力。
此前,在基于ArchXBench、BigCodeBench-Hard、BenchCAD、Spider 2.0、Harbor-Index等高难度工业级开源基准开展的Coding实操综合评测中,U2-Flash综合平均得分位列参评模型第二,并在构建编译与跨平台迁移、数字逻辑与芯片级RTL、2D矢量代码渲染、长程工具决策四个赛道中取得第一。
从工业级Coding 实操到智能体编程任务,U2-Flash 在不同类型的开发场景中接受检验。此次 Arena WebDev 榜单成绩,也进一步展现了模型将自然语言需求转化为网页成果的能力。
除Coding 外,U2-Flash 还具备推理、办公与 Agent 等能力,并结合医疗、医保、轨交、座舱等领域的实际需求,探索大模型在更多场景中的应用。