2026-09-17 14:16:35 中华网
[中国,上海,2026年9月9日] 昇腾团队在PyTorch Conference China 2026分享MindSpeed组件化赋能verl开源社区最新实践。verl对昇腾支持从“适配跟随”迈向“原生支持”,进入性能与易用性双升新阶段。会上分享FSDP-turbo、Async Flow异步RL、投机推理及RL训推一致性等RL技术实践。未来,昇腾将持续深耕低精训推、新模型结构及长序列性能等RL核心技术,并贡献至verl社区,助力开发者基于昇腾快速迭代模型后训练。
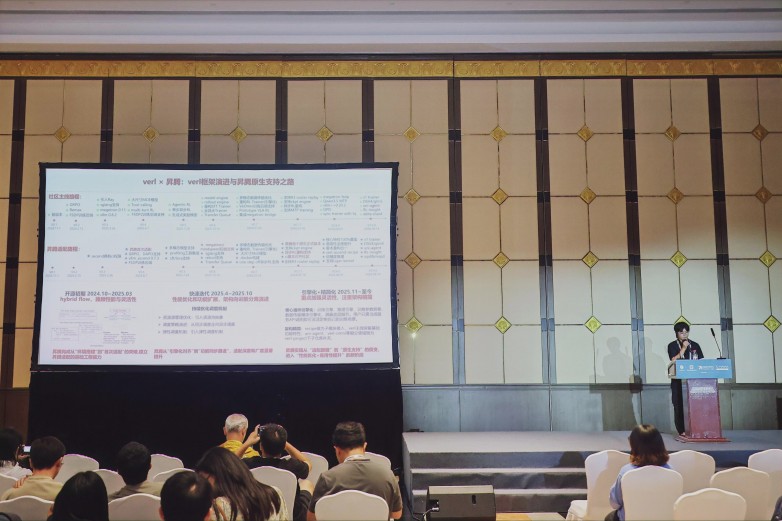
verl× 昇腾:verl框架演进与昇腾原生支持之路
verl作为PyTorch生态增长最快的RL社区,昇腾与其合作历经适配突破、功能同步至原生支持NPU的质变。双方联合构建RL训练框架,在资源管理、算法支持及训推加速等维度提供易开发、高性能能力,持续孵化极致优化实践。
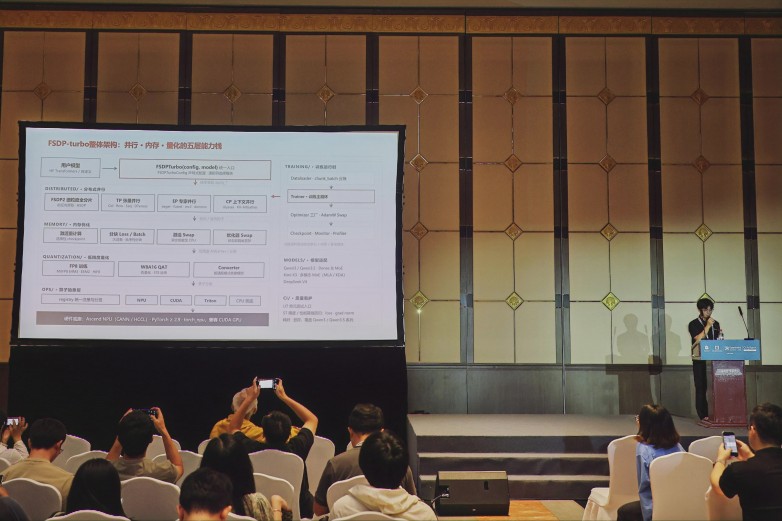
FSDP-turbo:一行代码完成并行策略组合和高性能训练
FSDP-turbo由昇腾团队开源,基于FSDP扩展,仅需一行代码即可在运行时按序装配,实现低侵入式迁移至多框架。其集成TP、EP、CP等分布式并行策略,支持激活重计算、分块Loss及优化器Swap等内存优化,兼容MXFP8/HIF8低精度量化。通过固定顺序装饰Module,确保语义正确。针对FSDP+EP场景,利用Triton、异步卸载及All2allvGroupMatmul等算子实现通算掩盖与显存优化,显著提升训练MFU,兼顾易用性与高性能。
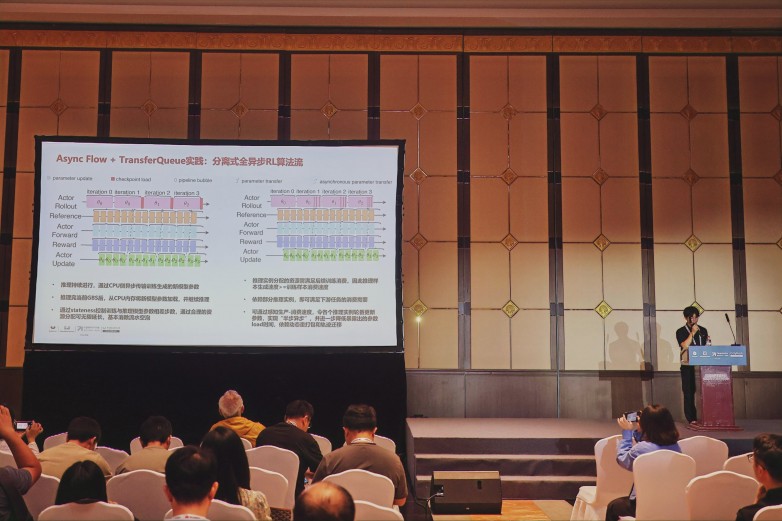
AsyncFlow异步流式RL-破解长尾之困,性能跃升3.8倍
AsyncFlow异步流式RL以训推解耦为核心,通过TransferQueue数据中枢与CheckpointEngine权重引擎,将推理(Rollout)与训练(Trainer)彻底解耦,突破同步模式的性能限制。在Qwen2.5-Math-7B场景下,较同步算法性能提升3.81倍,优于全异步方案。适度异步维持精度对齐,存在staleness配置甜点区。未来规划引入节点轮番更新及长尾样本集中生成,进一步挖掘性能潜力。
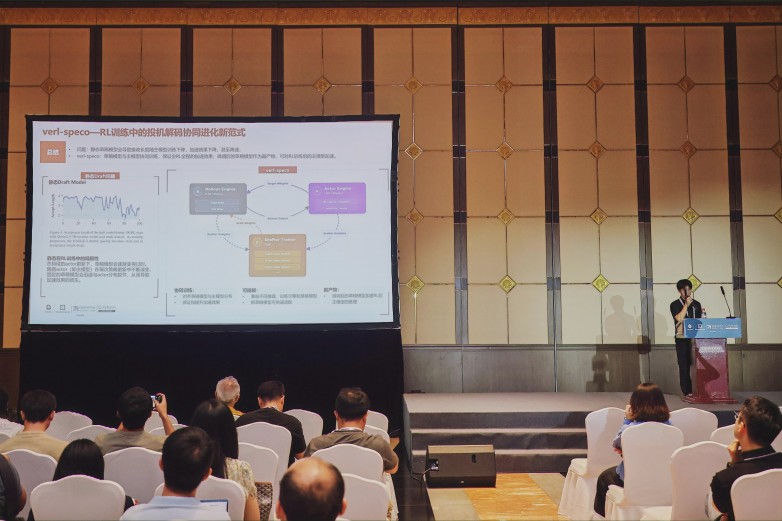
verl-SpeCo投机推理:“先猜后验”实现RL推理加速
昇腾团队深度参与共创的verl-SpeCo投机推理技术,在RL训练场景中实现目标模型与草稿模型的Co-Training协同训练机制,让草稿模型不再是一个静态的推理加速组件,而是成为RL训练闭环的一部分:随着主模型更新,草稿模型同步学习、持续演进,并通过权重热更新机制实时回到vLLM / SGLang Rollout引擎,形成从训练到推理的端到端加速闭环。
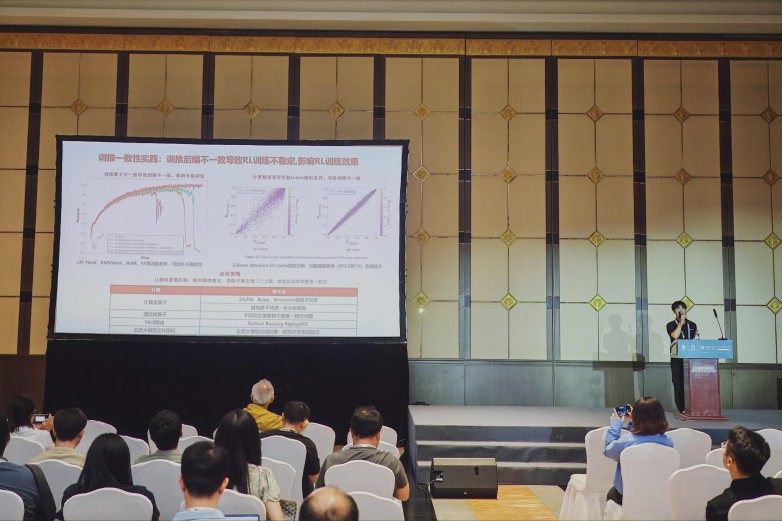
RL训推一致性:使能后训练长稳训练
对于RL训推一致性难题,昇腾通过实现Batch不变性、统一算子实现及修复框架差异,解决RoPE等模块不一致导致的训练不稳定。在Qwen3-30B上实现LogP Diff为0。在以GLM5模型为例的RL训练中,结合性能优化与稳定性调优策略,达成100步稳定上涨,LogP Diff维持千分位,显著提升模型训练精度稳定性。
未来,昇腾将继续深耕低精度方案(如 mxfp8、fp4)支持、拓展新模型结构适配、持续优化长序列 RL 性能等技术并原生贡献到verl社区,致力于构建更高效、更稳定的开源 RL 训练生态。